
Llevamos casi tres años hablando con la IA a través de una caja de texto. Escribes, esperas, lees un bloque de texto. Funciona, pero cada vez que tengo que comparar opciones, elegir una fecha o revisar unos datos en un chat pienso lo mismo: esto en una pantalla normal se resolvía con dos clics. Por lo visto no soy el único, porque Google, Apple, Vercel y los que mantienen los protocolos de agentes llevan desde 2025 moviéndose en la misma dirección: que la IA no solo conteste, sino que monte la interfaz que hace falta en cada momento, y que esa interfaz se mueva y cambie con el contenido.
En corto: Las interfaces fluidas para IA son pantallas que se generan o se recomponen según lo que pides y lo que la IA está haciendo, con movimiento que explica los cambios. Ya existen en productos reales (Gemini, AI Mode de Google, herramientas como el AI SDK de Vercel o el proyecto A2UI), pero no sustituyen al diseño: lo desplazan hacia definir componentes, límites y comportamientos.
El chat fue el primer paso, no el destino
Jakob Nielsen lo explicó bien en 2023, en AI: First New UI Paradigm in 60 Years. Hasta ahora le decíamos al ordenador qué hacer, paso a paso. Con la IA le decimos qué resultado queremos y él decide cómo llegar. Nielsen lo llama «especificación de resultados basada en la intención», y apunta que invierte quién tiene el control.
En el mismo artículo deja dos ideas que, años después, siguen siendo lo más útil del texto. La primera, que el chat obliga a escribir el problema en prosa, y que eso deja fuera a mucha gente: él considera probable que la mitad de la población de los países ricos no se exprese por escrito lo bastante bien como para sacar buenos resultados de un bot. La segunda, que pulsar cosas en una pantalla sigue siendo intuitivo y esencial, y que lo lógico es una interfaz híbrida: intención por un lado, elementos gráficos de toda la vida por otro.
Mi lectura: el chat no era la interfaz de la IA. Era lo más rápido de construir.
Qué es una interfaz generativa, sin humo
Nielsen Norman Group lo definió en 2024 en Generative UI and Outcome-Oriented Design: una interfaz generativa es la que una IA crea de forma dinámica, en tiempo real, para ajustarse a las necesidades y al contexto de cada usuario. El matiz importante está en a quién beneficia. No es usar la IA para diseñar más rápido (eso sería diseño asistido), es que cada usuario final vea una interfaz pensada para él en ese momento.
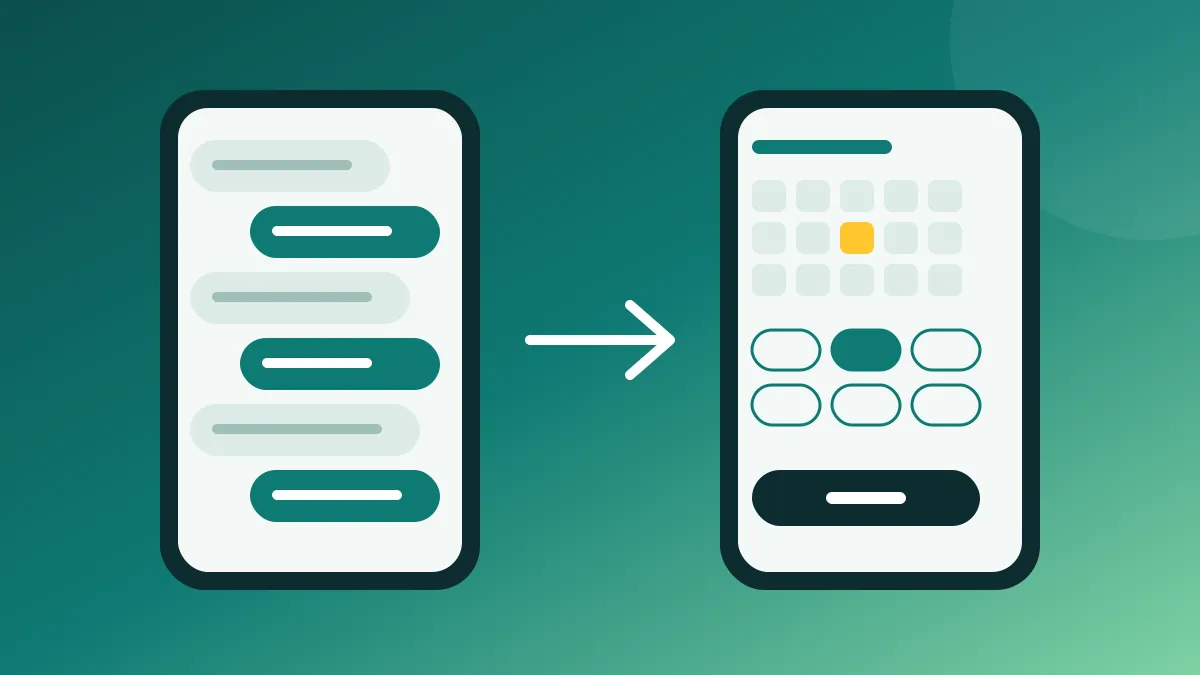
El ejemplo que más me gusta es el que usa Google al presentar A2UI, su proyecto abierto de diciembre de 2025: reservar mesa en un restaurante por chat. Para qué día, a qué hora, no hay hueco, qué horas tenéis… Un ida y vuelta lento. Su propuesta es que el agente genere un formulario sencillo con selector de fecha, de hora y un botón. Al final es lo que haría cualquier diseñador. La diferencia es que ahora lo decide la IA según la conversación, y no un flujo fijo.
Ya no es teoría: dónde se está viendo
En los últimos meses han pasado varias cosas que conviene separar, porque no son lo mismo.
Google: interfaces generadas al vuelo
En noviembre de 2025, Google Research publicó Generative UI: A rich, custom, visual interactive user experience for any prompt. Cuentan que su implementación, basada en Gemini 3 Pro, crea páginas, herramientas o simulaciones interactivas completas para cada petición, y que la están llevando a la app de Gemini (los experimentos «dynamic view» y «visual layout») y a AI Mode en el buscador.
Lo interesante para mí son los datos que dan, porque son honestos. En sus pruebas, las personas prefirieron claramente estas interfaces frente a las respuestas habituales de texto o markdown, pero sin tener en cuenta la velocidad de generación. Las webs diseñadas por expertos humanos siguieron siendo las preferidas. Y reconocen que a veces tardan un minuto o más y que hay imprecisiones ocasionales. Es decir: funciona, gusta, y todavía es lenta y no siempre acierta.
Vercel y los protocolos: componentes que la IA elige
En el lado de desarrollo, el planteamiento es más controlado. En la documentación de interfaces generativas del AI SDK de Vercel la idea es sencilla: le das al modelo herramientas (por ejemplo, consultar el tiempo), el modelo decide cuándo usarlas y el resultado se pinta con un componente que tú has diseñado. Incluso los estados están previstos: cargando, resultado o error.
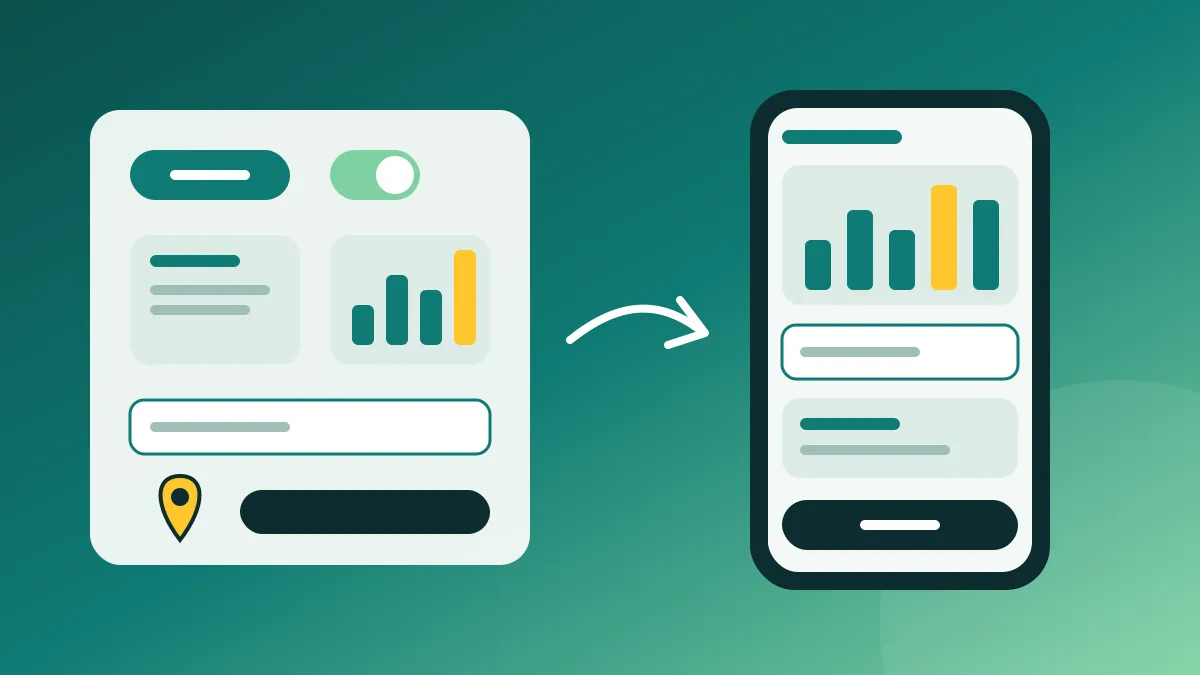
A2UI va en la misma línea: el agente no manda código, manda una descripción de qué componentes quiere usar, y la aplicación los pinta con sus propios estilos a partir de un catálogo de piezas aprobadas. Google lo justifica por seguridad, pero a mí me parece igual de importante por marca: la interfaz sigue pareciendo tuya. Y las MCP Apps del Model Context Protocol resuelven otra parte: que un servicio pueda devolver una interfaz interactiva (gráficos, formularios, paneles) dentro de la propia conversación. Su documentación lo resume en una frase con la que estoy de acuerdo: las respuestas de texto solo llegan hasta cierto punto.
Apple: el material que se adapta al contenido
Apple no habla de IA en esto, pero va por el mismo camino desde otro lado. En junio de 2025 presentó Liquid Glass, su nuevo lenguaje visual, y Alan Dye, su vicepresidente de diseño de interfaz, lo describe como un material que «se transforma según tu contenido o contexto». Botones, barras y menús que cambian según lo que hay debajo. Es una interfaz que deja de ser un decorado fijo y empieza a reaccionar.
Por qué el movimiento es la parte importante de las interfaces fluidas para IA
Cuando una pantalla se compone sola, el riesgo es que el usuario no entienda qué ha cambiado ni por qué. Ahí es donde entra el movimiento, y no como adorno.
En 2018, en la charla Designing Fluid Interfaces de la WWDC, el equipo de Apple dijo una frase que sigo usando: no es que nuestras interfaces deban ser fluidas, es que nosotros somos fluidos y las interfaces tienen que poder responder a eso. De esa charla me quedo con cuatro principios que encajan muy bien con una IA que actúa:
- Responder al instante. Cualquier retraso rompe la sensación de que la herramienta es una extensión tuya. Con una IA que tarda segundos, esto obliga a enseñar algo desde el primer momento: que ha entendido, qué está haciendo.
- Poder interrumpir y cambiar de opinión. Si la IA está montando algo y ves que no va por ahí, tienes que poder pararla o corregirla a mitad, no esperar a que termine.
- Coherencia espacial. Lo que sale por un lado vuelve por el mismo. Si un panel aparece, el usuario tiene que saber de dónde ha venido y a dónde se va.
- Movimiento con propósito. Recomiendan empezar sin rebote y usarlo solo cuando el gesto lo justifica. Incluso evitan hablar de «duración», porque el movimiento debe ser un comportamiento continuo, no una animación cerrada.
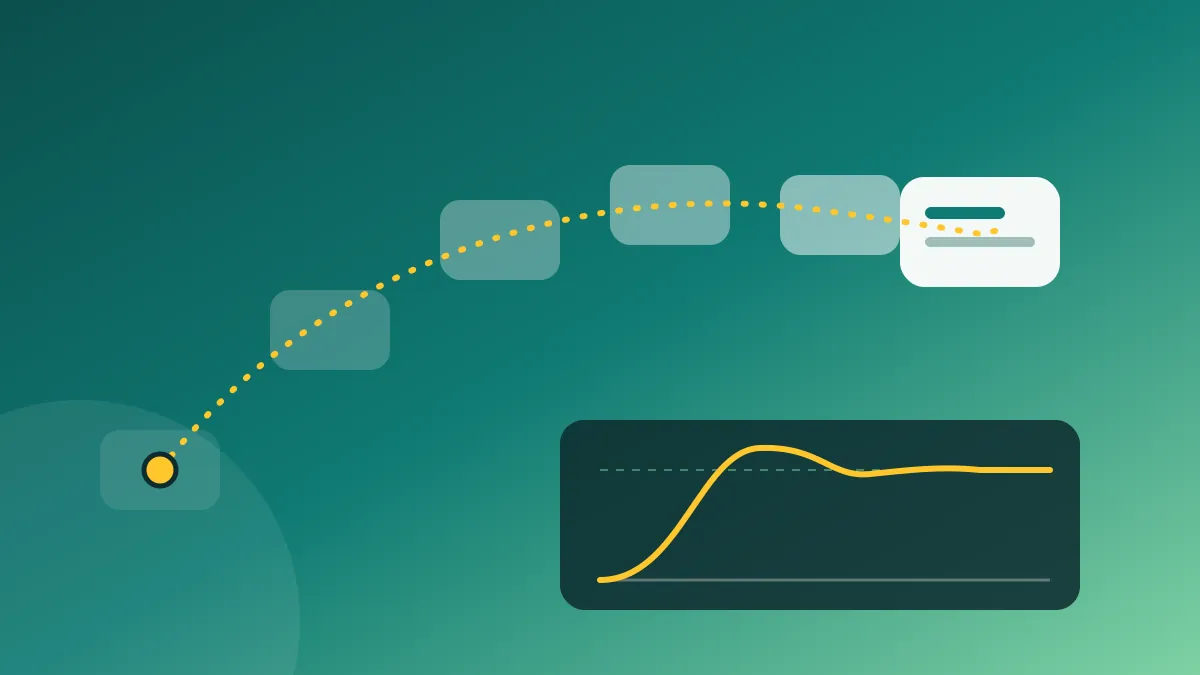
Nielsen Norman Group lo dice de forma más seca en The Role of Animation and Motion in UX: la animación tiene que ser discreta, breve y sutil, y sirve para dar feedback, explicar cambios de estado y orientar al usuario. El movimiento llama la atención aunque no queramos, así que si no aporta, molesta.
En las interfaces fluidas para IA esto pesa el doble. Si la IA añade una tarjeta, reordena una lista o sustituye un gráfico, el movimiento es lo que le dice al usuario «esto es nuevo, esto ha cambiado, esto sigue donde estaba». Sin eso, cada respuesta es una pantalla distinta que hay que volver a leer entera.
Lo que no me convence (todavía)
Tras sopesar los pros y contras, creo que hay tres problemas que no se resuelven solo con mejores modelos.
La consistencia. El propio artículo de NN/g lo avisa: si la interfaz cambia según tus necesidades, puedes encontrarte una pantalla distinta cada vez, y eso obliga a reaprender. Gran parte de lo que sabemos usar se basa en convenciones (el logo arriba a la izquierda, el botón principal en su sitio). Una interfaz que lo cambia todo cada vez es más cansada, no menos.
La velocidad. Google reconoce que su implementación puede tardar un minuto o más. Para aprender sobre un tema puede valer. Para reservar una mesa, no. Para mí aquí está la razón de que el modelo de componentes predefinidos (Vercel, A2UI) tenga más recorrido a corto plazo en productos de negocio: es más rápido, más predecible y se puede probar.
La accesibilidad del movimiento. Ya escribí sobre la accesibilidad web como decisión de producto, y aquí aplica igual. El criterio 2.3.3 de WCAG pide que la animación provocada por la interacción se pueda desactivar, salvo que sea esencial, porque hay personas a las que el movimiento les provoca mareo, náuseas o migrañas. Es un criterio de nivel AAA, pero en una interfaz que se mueve mucho no lo veo opcional. Los navegadores ya lo facilitan con prefers-reduced-motion, que detecta si el usuario ha pedido reducir el movimiento en su sistema.
Qué cambia en el trabajo de diseño de producto
Aquí es donde veo el cambio más grande, y no es que desaparezca el diseño. NN/g lo llama diseño orientado a resultados: en lugar de diseñar cada pantalla, el diseñador define objetivos, límites y reglas dentro de las que la IA genera la interfaz. Ponen un ejemplo que me parece muy práctico: clasificar la información en «hay que mostrar», «conviene mostrar» y «nunca mostrar».
Si lo llevo a cómo trabajo con equipos, lo concretaría así:
- Un catálogo de componentes cerrado y bien hecho. Accesible, con sus estados (cargando, vacío, error, resultado) y con su movimiento definido. Si la IA solo puede usar piezas buenas, el resultado parte de un mínimo de calidad.
- Reglas escritas, no implícitas. Qué puede decidir la IA (orden, qué componente usar, qué datos enseñar) y qué no (precios, condiciones legales, el botón de pago).
- Un lenguaje de movimiento común. Cómo entra algo nuevo, cómo se sustituye algo, cómo se indica que la IA está trabajando. Pocas reglas, siempre las mismas.
- El estado de la IA siempre visible. Pensando, buscando, montando, terminado. Es lo que Nielsen llama visibilidad del estado del sistema, el primero de sus principios de usabilidad, y con una IA que actúa por ti es lo que más confianza da.
- Probar con personas, no con capturas. Una interfaz que cambia según el contexto no se valida con un prototipo estático. Hay que ver cómo reacciona la gente cuando la pantalla se mueve.
Hace años escribí sobre cómo mejorar la interacción de un servicio web y sobre cuando Google actualizó su guía de Material Design. Releyéndolos, lo que ha cambiado es quién compone la pantalla. Lo que no ha cambiado es lo que hace que funcione: que el usuario entienda dónde está, qué ha pasado y qué puede hacer después.
Cómo se lo cuento a un cliente
Al cliente no le interesa si es generativa, adaptativa o fluida. Le interesa si su producto va a ser más fácil de usar y si va a vender más. Le diría que no hace falta reconstruir nada para empezar. Que elija una tarea donde hoy el usuario tenga que escribir mucho o dar muchos pasos (buscar, comparar, configurar, reservar) y pruebe ahí una respuesta con componentes en lugar de texto. Con métricas claras: tiempo hasta completar la tarea, errores y abandonos. Si mejora, se amplía. Si no, se ha aprendido barato.
Lo que no le prometería es una interfaz que se diseña sola. Hoy no existe, y por lo que cuentan los propios fabricantes, todavía tardará.
¿Qué son las interfaces fluidas para IA?
Interfaces que se generan o se recomponen según lo que pide el usuario y lo que hace la IA, y que usan el movimiento para explicar los cambios, en lugar de responder siempre con un bloque de texto en un chat.
¿Qué diferencia hay entre una interfaz generativa y una adaptativa?
Una interfaz adaptativa cambia elementos de un diseño existente según el contexto. Una interfaz generativa va más allá: la IA decide qué componentes mostrar y cómo combinarlos para cada petición, a veces creando la pantalla entera.
¿Las interfaces generativas van a sustituir al chat?
No del todo. Lo más probable, como apuntaba Nielsen, es una interfaz híbrida: escribir o hablar para expresar la intención, y componentes gráficos para ver, comparar y decidir.
¿Cómo se hace accesible una interfaz con mucho movimiento?
Respetando la preferencia de movimiento reducido del sistema, permitiendo desactivar la animación que no sea esencial (criterio 2.3.3 de WCAG) y asegurando que la interfaz se entiende igual sin animación.
Dónde me deja todo esto
En cualquier caso, creo que las interfaces fluidas para IA son una buena noticia. Durante estos años la IA nos ha obligado a adaptarnos a ella: aprender a escribir peticiones, leer respuestas largas, copiar y pegar. Ahora empieza a ser al revés, la interfaz se adapta a lo que necesitas. Pero para que eso funcione hace falta lo de siempre: buenos componentes, reglas claras, movimiento con sentido y probar con personas reales.
Si estás pensando en llevar algo de esto a tu producto y quieres que lo veamos juntos, tienes mi página de diseño de producto. Y si te interesa cómo está cambiando la IA el lado del tráfico, escribí sobre cómo aparecer en AI Overviews y AI Mode.